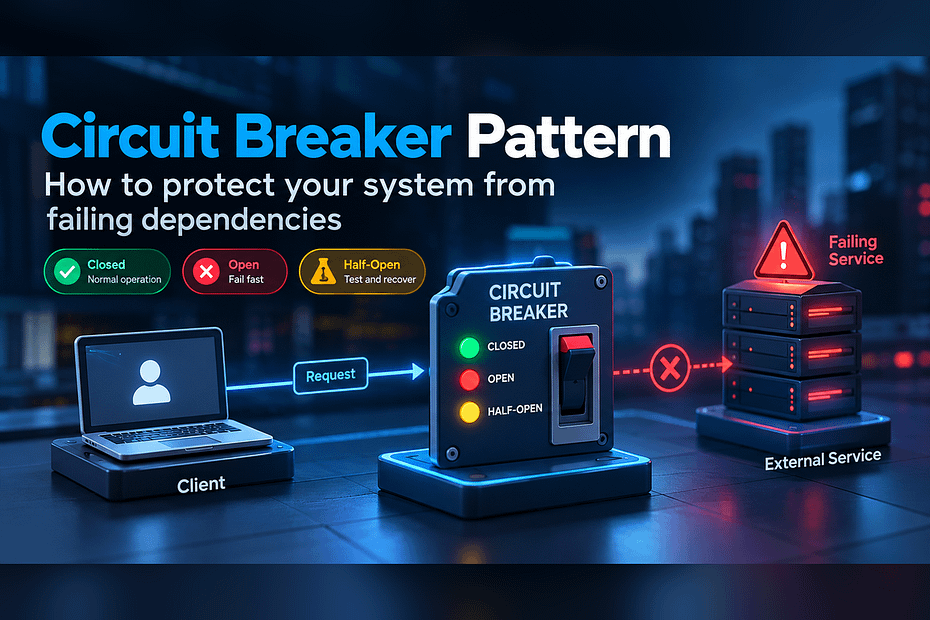
Em sistemas distribuídos, uma chamada para outro serviço nunca deve ser tratada como se fosse uma simples chamada de método dentro da mesma aplicação.
Quando uma aplicação depende de outro serviço por meio da rede, surgem novas possibilidades de falha: timeouts, indisponibilidade, latência elevada, erros HTTP, problemas de conexão e sobrecarga.
O problema se torna ainda mais interessante quando uma dependência começa a falhar repetidamente. Se a aplicação continuar enviando requisições normalmente, ela pode consumir suas próprias threads, conexões, memória e recursos de processamento tentando chamar um serviço que não está respondendo corretamente.
É nesse cenário que entra o Circuit Breaker Pattern.
O objetivo do Circuit Breaker não é fazer uma dependência voltar a funcionar. Seu objetivo é impedir que uma dependência que está falhando continue prejudicando o restante do sistema.
O que é o Circuit Breaker Pattern?
O Circuit Breaker é um padrão de resiliência utilizado para controlar chamadas a uma dependência externa que apresenta falhas persistentes.
A ideia é simples: enquanto a dependência está saudável, as requisições são normalmente encaminhadas. Porém, quando um determinado limite de falhas é atingido, o circuito é aberto e novas chamadas deixam de ser enviadas temporariamente.
Sam Newman descreve o mecanismo da seguinte maneira:
“With a circuit breaker, after a certain number of requests to the downstream resource have failed, the circuit breaker is blown. All further requests fail fast while the circuit breaker is in its blown state.”
Sam Newman, Building Microservices: Designing Fine-Grained Systems, p. 212.
A ideia central está justamente no fail fast: depois que o sistema identifica que a dependência está apresentando falhas persistentes, não faz sentido continuar esperando indefinidamente por ela.
Em vez disso, o sistema interrompe temporariamente as chamadas e permite que a dependência tenha tempo para se recuperar.
Por que simplesmente usar Timeout não é suficiente?
Um dos mecanismos mais importantes para chamadas remotas é o Timeout.
Se uma API não responder, não queremos manter uma thread esperando indefinidamente. Por isso, toda chamada para fora do processo deveria possuir algum limite de tempo.
Newman recomenda explicitamente o uso de timeouts para chamadas que saem do processo:
“Put timeouts on all out-of-process calls, and pick a default timeout for everything.”
Sam Newman, Building Microservices: Designing Fine-Grained Systems, p. 211.
O Timeout, entretanto, resolve apenas uma parte do problema.
Imagine uma aplicação que chama um serviço de pagamentos. O serviço começa a responder muito lentamente. Cada requisição demora vários segundos até atingir o timeout.
Agora imagine que centenas ou milhares de requisições estejam fazendo exatamente a mesma coisa.
Mesmo que exista um timeout, a aplicação ainda pode passar um período considerável consumindo recursos tentando chamar uma dependência que continua indisponível.
É aqui que o Circuit Breaker complementa o Timeout.
Timeout limita quanto tempo uma chamada individual pode esperar.
Circuit Breaker decide quando devemos parar temporariamente de realizar novas chamadas para aquela dependência.
O problema das falhas em cascata
Considere uma arquitetura simples:
- API de pedidos
- Serviço de pagamentos
- Serviço de estoque
- Serviço de entrega
Agora imagine que o serviço de pagamentos começa a apresentar latência elevada.
A API de pedidos continua enviando requisições. As requisições ficam aguardando respostas. Threads e conexões começam a permanecer ocupadas por mais tempo.
À medida que a carga aumenta, mais recursos são consumidos. A aplicação pode começar a ficar lenta mesmo que ela própria esteja funcionando corretamente.
Eventualmente, o problema de um serviço pode começar a afetar outros componentes.
Esse é um dos riscos mais importantes de arquiteturas distribuídas: uma falha localizada pode se propagar por meio das dependências síncronas.
Esse comportamento é especialmente perigoso quando temos cadeias longas de chamadas:
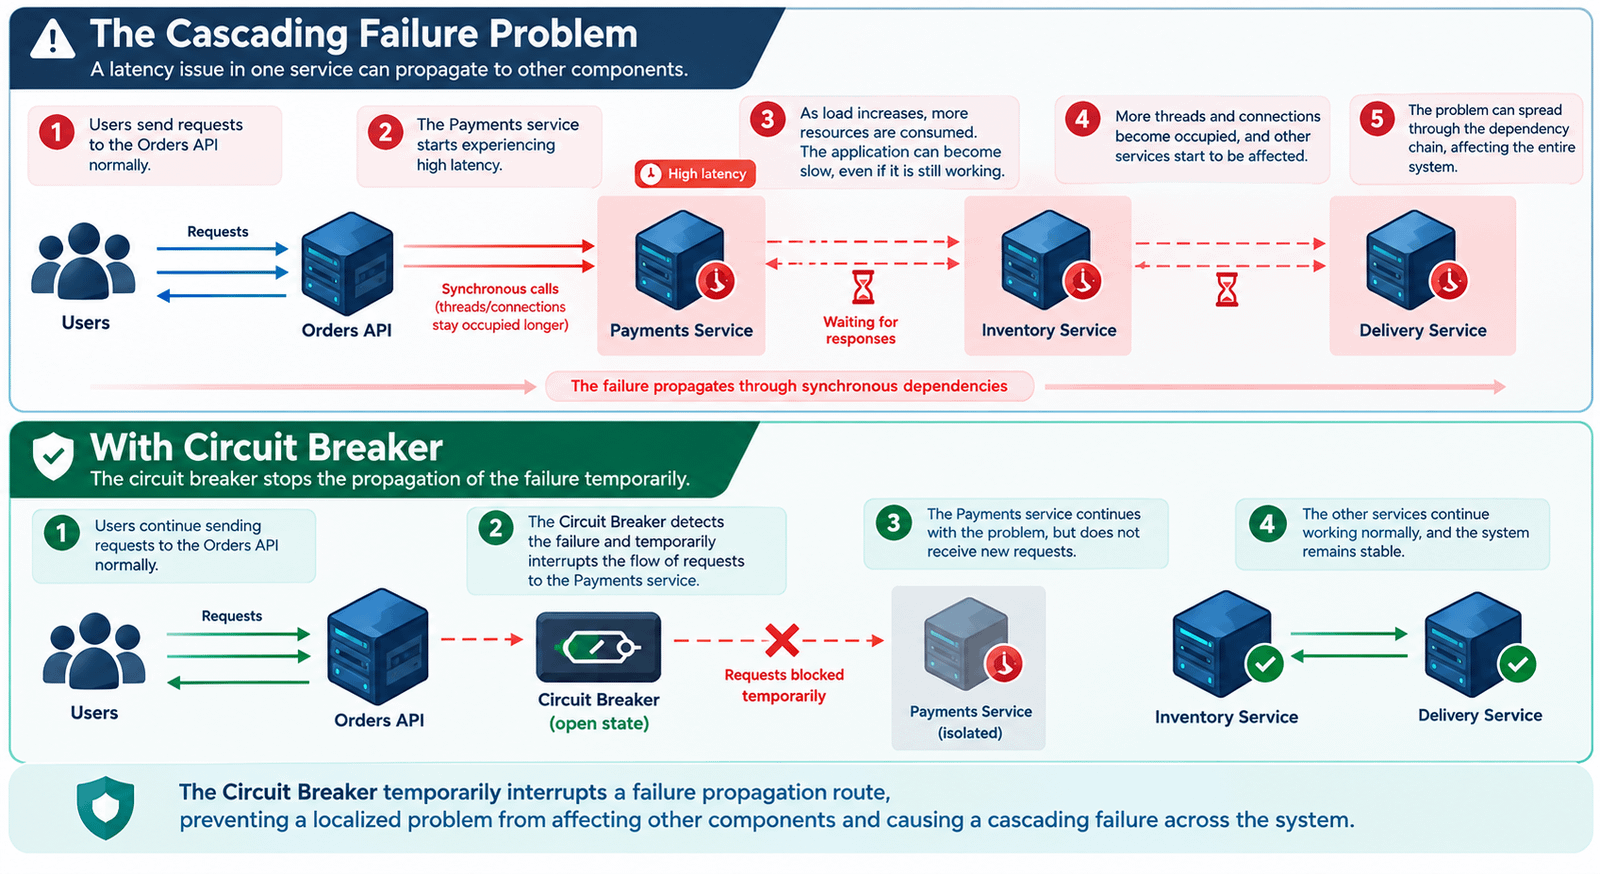
Se o banco externo apresentar problemas e todos os serviços continuarem esperando por ele, o impacto pode subir pela cadeia inteira.
O Circuit Breaker atua justamente nesse ponto: interromper temporariamente uma das rotas de propagação da falha.
Circuit Breaker e confiabilidade
O conceito está diretamente relacionado à reliability, ou confiabilidade, de sistemas.
Martin Kleppmann define confiabilidade a partir da capacidade do sistema de continuar funcionando corretamente mesmo diante de situações adversas:
“The system should continue to work correctly […] even in the face of adversity.”
Martin Kleppmann, Designing Data-Intensive Applications, p. 4.
Isso é importante porque confiabilidade não significa simplesmente que os componentes nunca falham.
Em sistemas reais, falhas acontecem. O objetivo da arquitetura é determinar como o sistema irá se comportar quando elas acontecerem.
Um Circuit Breaker é, portanto, uma estratégia para lidar com uma determinada classe de falhas: dependências remotas que estão falhando de forma persistente ou apresentando comportamento degradado.
Os três estados do Circuit Breaker
O Circuit Breaker normalmente é representado por três estados:
- Closed
- Open
- Half-Open
1. Closed
No estado Closed, o circuito está funcionando normalmente.
As requisições são encaminhadas para a dependência e o Circuit Breaker acompanha os resultados.
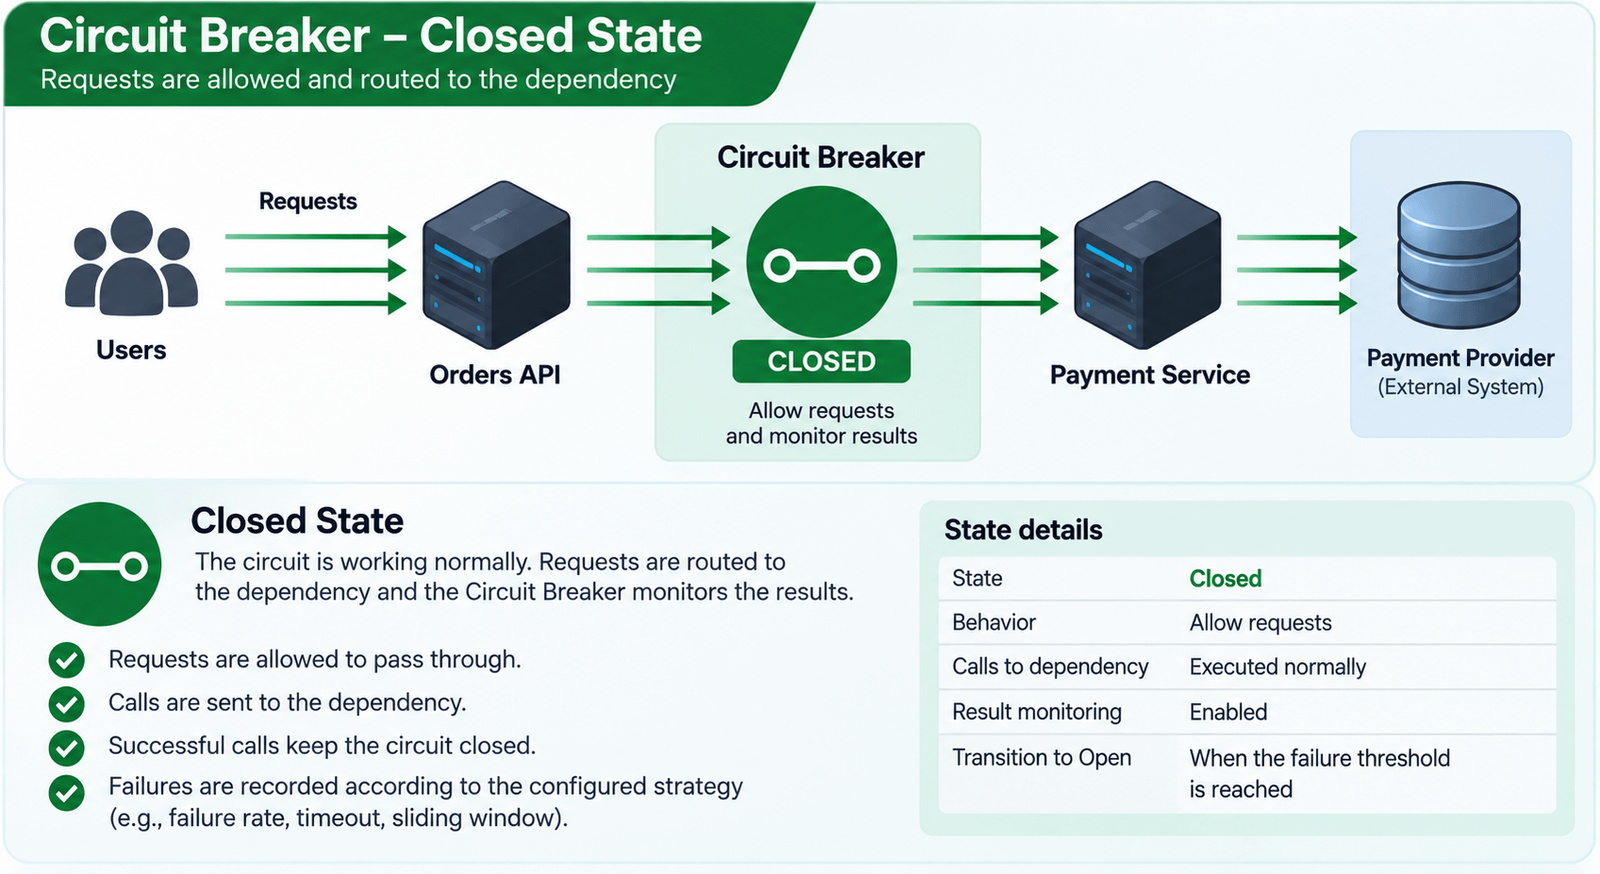
Se as chamadas forem bem-sucedidas, o circuito continua fechado.
Quando começam a ocorrer falhas, o Circuit Breaker registra essas ocorrências de acordo com sua estratégia de avaliação.
2. Open
Quando o limite configurado de falhas é atingido, o circuito passa para Open.
Nesse estado, as chamadas para a dependência são bloqueadas.
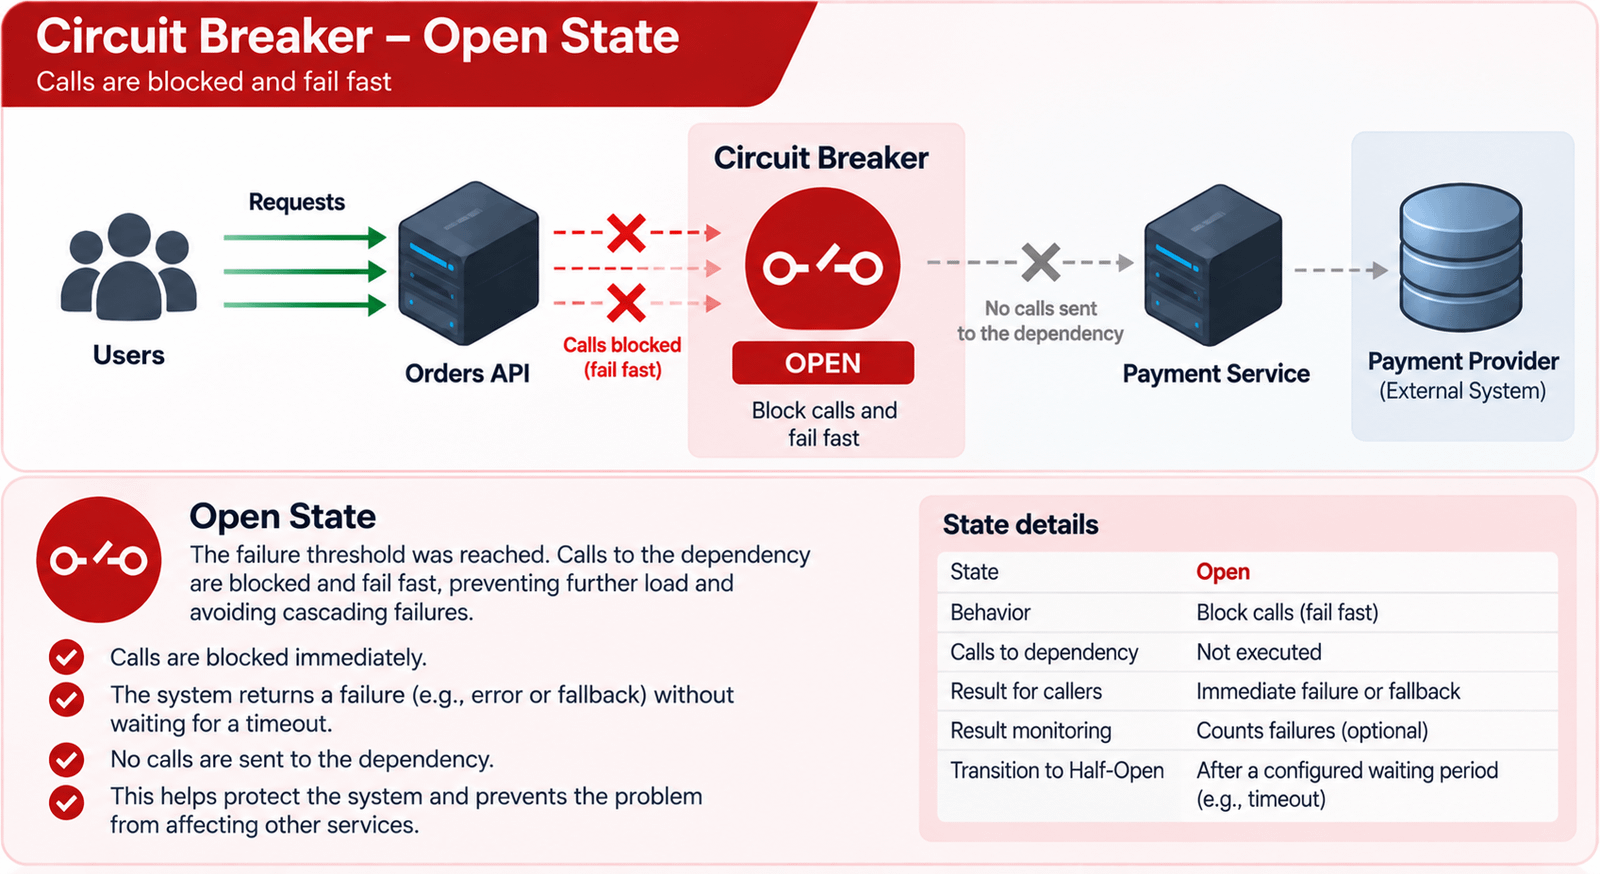
Esse comportamento é o chamado fail fast.
Em vez de executar uma chamada que provavelmente irá falhar ou ficar esperando por um timeout, o sistema responde imediatamente com uma falha ou aplica alguma estratégia de degradação.
Newman destaca justamente essa diferença: enquanto o circuito está aberto, as requisições subsequentes falham rapidamente em vez de continuarem atingindo a dependência problemática.
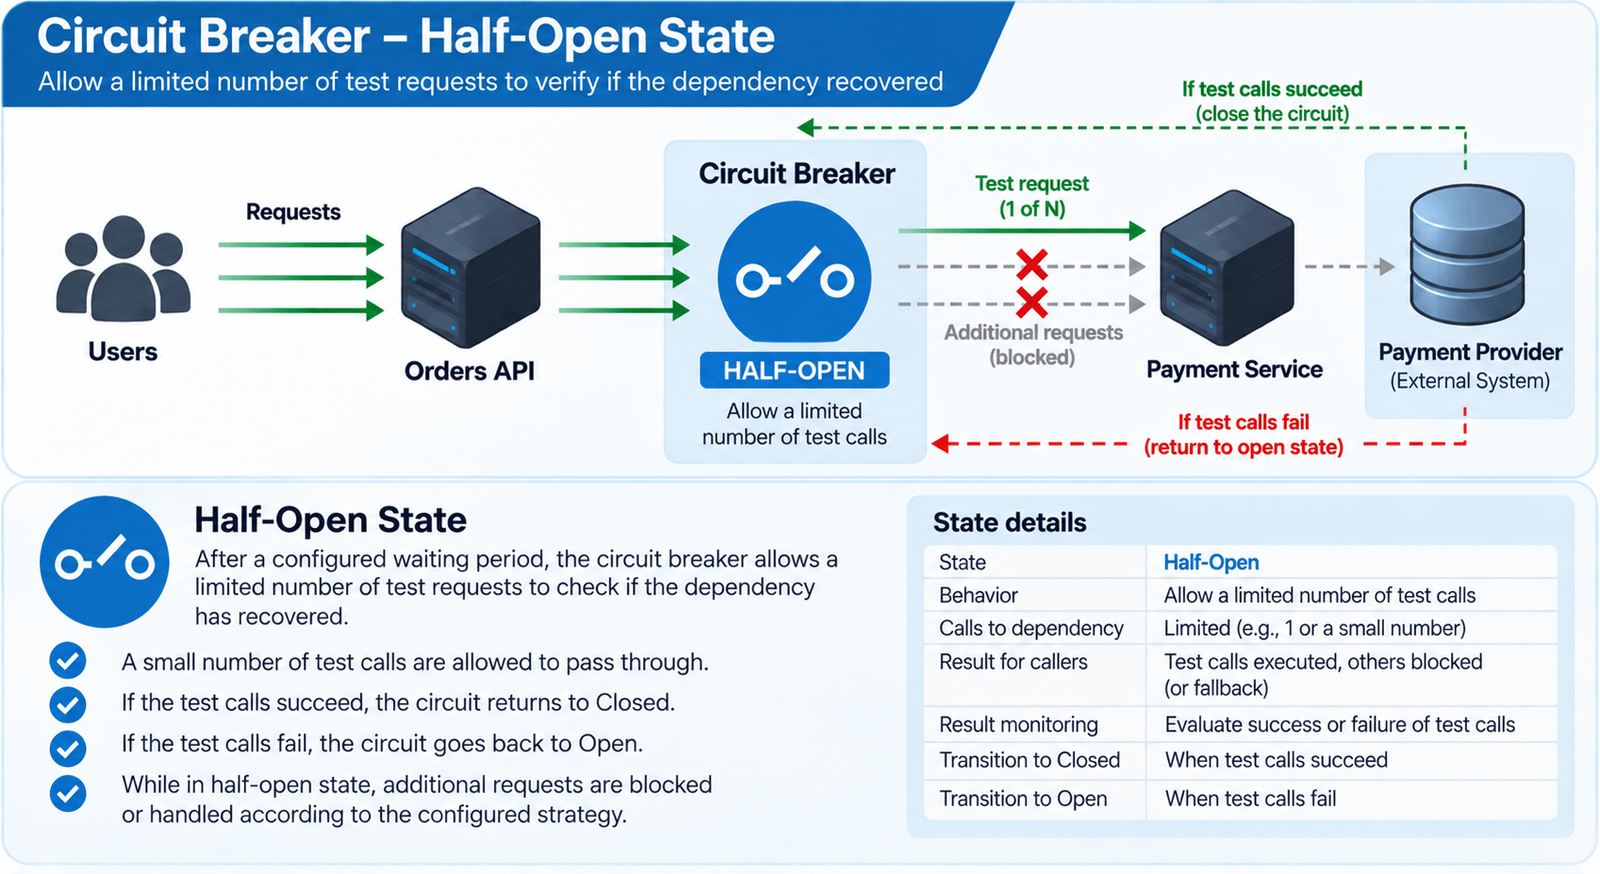
3. Half-Open
O Circuit Breaker não pode permanecer aberto para sempre.
Depois de determinado período, o sistema precisa descobrir se a dependência se recuperou.
É para isso que existe o estado Half-Open.
Nesse estado, o Circuit Breaker permite uma quantidade limitada de chamadas de teste.
Se essas chamadas forem bem-sucedidas, o circuito pode voltar para Closed.
Se as falhas continuarem, o circuito retorna para Open.
Um exemplo prático
Imagine uma plataforma de telemetria veicular.
Uma Unidade Embarcada (On-board Unit – OBU) envia dados para um serviço responsável por receber e processar informações do veículo.
O fluxo inicialmente funciona normalmente:

Agora imagine que o serviço de telemetria fique indisponível.
As requisições começam a falhar. A aplicação realiza algumas tentativas e continua recebendo erros.
Depois que o limite configurado é atingido, o Circuit Breaker abre o circuito.
A partir desse momento, novas requisições não são enviadas para o serviço indisponível.
Isso evita que o sistema continue desperdiçando recursos com chamadas que provavelmente irão falhar.
Depois de um período, o circuito passa para Half-Open e realiza algumas chamadas de teste. Se o serviço estiver saudável novamente, o circuito volta para Closed.
O que caracteriza uma falha?
Uma decisão importante na implementação de um Circuit Breaker é determinar o que será considerado uma falha.
Não existe uma regra universal.
Em chamadas HTTP, por exemplo, uma aplicação pode considerar como falha:
- Timeout;
- Falha de conexão;
- Respostas HTTP 5xx;
- Determinados erros de infraestrutura;
- Exceções específicas do cliente HTTP.
Sam Newman apresenta justamente timeout e respostas HTTP 5xx como exemplos de falhas que podem ser utilizadas para determinar quando o circuito deve ser aberto.
Por outro lado, um HTTP 400 normalmente representa um problema na requisição do cliente e não necessariamente uma falha da dependência.
Por isso, colocar indiscriminadamente qualquer erro no contador do Circuit Breaker pode produzir comportamento incorreto.
Como escolher o limite de falhas?
Outro ponto importante é determinar quantas falhas são necessárias para abrir o circuito.
Por exemplo, podemos definir uma política conceitual como:
- Falha 1:
Closed - Falha 2:
Closed - Falha 3:
Closed - Falha 4:
Closed - Falha 5:
Open– limite de falhas atingido.
O número 5 é apenas um exemplo. Não existe um valor universalmente correto.
Se o limite for muito baixo, uma pequena instabilidade poderá abrir o circuito desnecessariamente.
Se for muito alto, o sistema poderá continuar enviando chamadas para uma dependência problemática durante tempo demais.
O próprio Newman chama atenção para essa dificuldade: é necessário evitar tanto abrir o circuito cedo demais quanto esperar tempo demais antes de interromper as chamadas.
Circuit Breaker e Retry
É comum confundir Retry com Circuit Breaker, mas eles resolvem problemas diferentes.
Retry responde a uma pergunta:
“Vale a pena tentar novamente?”
Circuit Breaker responde a outra:
“Essa dependência está falhando de forma persistente a ponto de devermos parar temporariamente de chamá-la?”
Retry é particularmente útil quando existe uma possibilidade razoável de que a falha seja temporária.
Por exemplo:
- uma interrupção momentânea de rede;
- um timeout transitório;
- uma falha durante failover;
- uma sobrecarga temporária.
Mas, se a dependência está continuamente indisponível, continuar realizando retries pode simplesmente aumentar a quantidade de tráfego direcionado para um serviço que já está com problemas.
Por isso, Retry e Circuit Breaker podem trabalhar juntos.
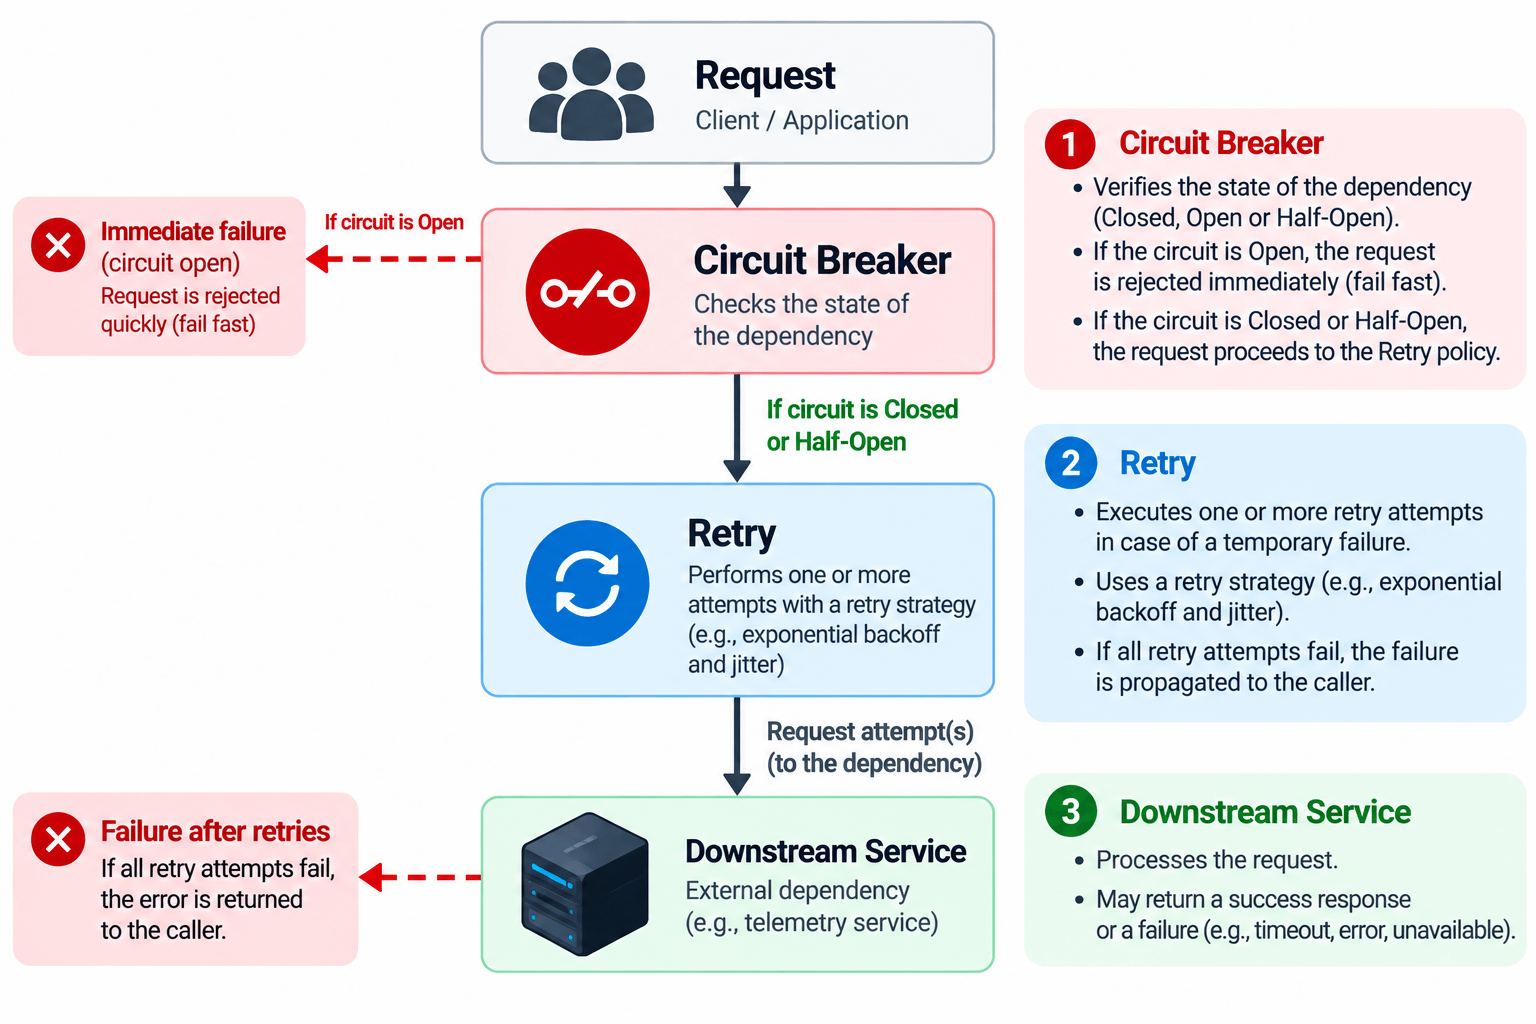
O detalhe mais importante é que a ordem exata e o comportamento dependem da biblioteca, da arquitetura e da política de resiliência adotada. O princípio permanece: não transformar uma falha persistente em uma tempestade de novas tentativas.
Circuit Breaker e Bulkhead
Outro padrão frequentemente associado ao Circuit Breaker é o Bulkhead.
A ideia do Bulkhead é isolar recursos para impedir que um problema em uma dependência consuma todos os recursos disponíveis.
Imagine uma aplicação que possui um único pool de conexões utilizado para várias dependências.
Se uma delas começar a responder muito lentamente, pode consumir grande parte das conexões disponíveis. Outras operações, mesmo dependentes de serviços saudáveis, começam então a sofrer.
O Circuit Breaker pode impedir novas chamadas depois que o problema é identificado, enquanto o Bulkhead ajuda a limitar o impacto do consumo de recursos.
São mecanismos complementares, não substitutos.
O que fazer quando o circuito está aberto?
Abrir o circuito é apenas uma parte da solução.
O sistema ainda precisa decidir qual comportamento terá enquanto a dependência estiver indisponível.
Dependendo do contexto, algumas alternativas são possíveis.
Fail fast
A aplicação retorna imediatamente um erro para o chamador.
Essa abordagem costuma ser adequada para chamadas síncronas nas quais não existe uma alternativa razoável.
Fallback
A aplicação utiliza uma resposta alternativa.
Por exemplo, pode retornar uma informação previamente armazenada em cache ou uma funcionalidade simplificada.
Degradação funcional
Em vez de falhar completamente, o sistema continua funcionando com menos funcionalidades.
Processamento assíncrono
Quando o domínio permite, a operação pode ser colocada em uma fila para processamento posterior.
Newman destaca justamente essa diferença: para determinadas tarefas assíncronas pode fazer sentido colocar as requisições em uma fila e tentar novamente posteriormente, enquanto em uma cadeia síncrona pode ser preferível falhar rapidamente ou degradar a funcionalidade.
Circuit Breaker não elimina a falha
É importante entender uma limitação fundamental:
Circuit Breaker não torna uma dependência disponível.
Se o serviço de pagamentos estiver indisponível, o Circuit Breaker não irá recuperá-lo.
O que ele faz é impedir que o problema continue consumindo recursos e afetando componentes que ainda poderiam permanecer funcionando.
Por isso, o padrão deve ser entendido como um mecanismo de contenção de falhas, e não como um mecanismo de recuperação automática.
Observabilidade é parte da solução
Um Circuit Breaker sem observabilidade pode esconder problemas importantes.
É importante acompanhar pelo menos:
- quantidade de falhas;
- quantidade de timeouts;
- quantidade de circuitos abertos;
- tempo em que o circuito permanece aberto;
- quantidade de transições entre estados;
- quantidade de requisições rejeitadas pelo circuito;
- taxa de sucesso durante Half-Open.
Essas métricas ajudam a responder perguntas importantes:
- O circuito está abrindo frequentemente?
- O threshold está muito baixo?
- A dependência realmente está apresentando problemas?
- O timeout está configurado corretamente?
- O circuito permanece aberto por tempo demais?
- A aplicação possui um fallback adequado?
Sem essas informações, a configuração do Circuit Breaker acaba sendo baseada apenas em suposições.
Como configurar um Circuit Breaker?
Não existe uma configuração universal que funcione para todos os sistemas.
Alguns dos parâmetros que normalmente precisam ser avaliados são:
- Failure threshold: quantidade ou proporção de falhas necessária para abrir o circuito;
- Open duration: quanto tempo o circuito permanece aberto;
- Half-Open strategy: quantas requisições serão utilizadas para testar a recuperação;
- Failure classification: quais erros serão considerados falhas;
- Fallback: qual comportamento será adotado quando as chamadas forem bloqueadas.
Uma configuração agressiva demais pode gerar falsos positivos. Uma configuração permissiva demais pode permitir que uma dependência problemática continue prejudicando o sistema.
Sam Newman recomenda começar com configurações sensatas e ajustá-las de acordo com o comportamento observado no sistema.
Circuit Breaker não deve ser usado indiscriminadamente
Outro ponto importante é que Circuit Breaker não deve ser colocado automaticamente em todas as chamadas do sistema apenas porque a arquitetura utiliza microservices.
Antes de utilizar o padrão, é necessário entender:
- qual dependência está sendo chamada;
- qual é o custo de uma falha;
- qual é o comportamento esperado quando ela está indisponível;
- se a operação pode ser executada posteriormente;
- se existe fallback;
- se a operação é síncrona ou assíncrona;
- qual é o impacto de bloquear novas chamadas.
Um Circuit Breaker mal configurado pode simplesmente transformar erros reais em erros mais rápidos, sem resolver o problema arquitetural.
Circuit Breaker em arquiteturas distribuídas
Quanto mais uma arquitetura depende de comunicação síncrona entre serviços, maior tende a ser a importância de mecanismos que controlem falhas, latência e disponibilidade.
Isso ocorre porque uma chamada síncrona cria uma dependência temporal: o serviço A precisa esperar o serviço B.
Se C estiver lento, B pode ficar lento. Se B ficar lento, A pode ficar lento.
O Circuit Breaker ajuda a interromper essa cadeia quando uma dependência apresenta falhas persistentes.
Isso não significa que toda comunicação síncrona seja ruim. Significa que dependências síncronas precisam ser tratadas como possíveis pontos de falha.
Timeout, Retry, Circuit Breaker e Bulkhead juntos
Esses padrões não competem necessariamente entre si.
Eles podem fazer parte de uma estratégia maior de resiliência:
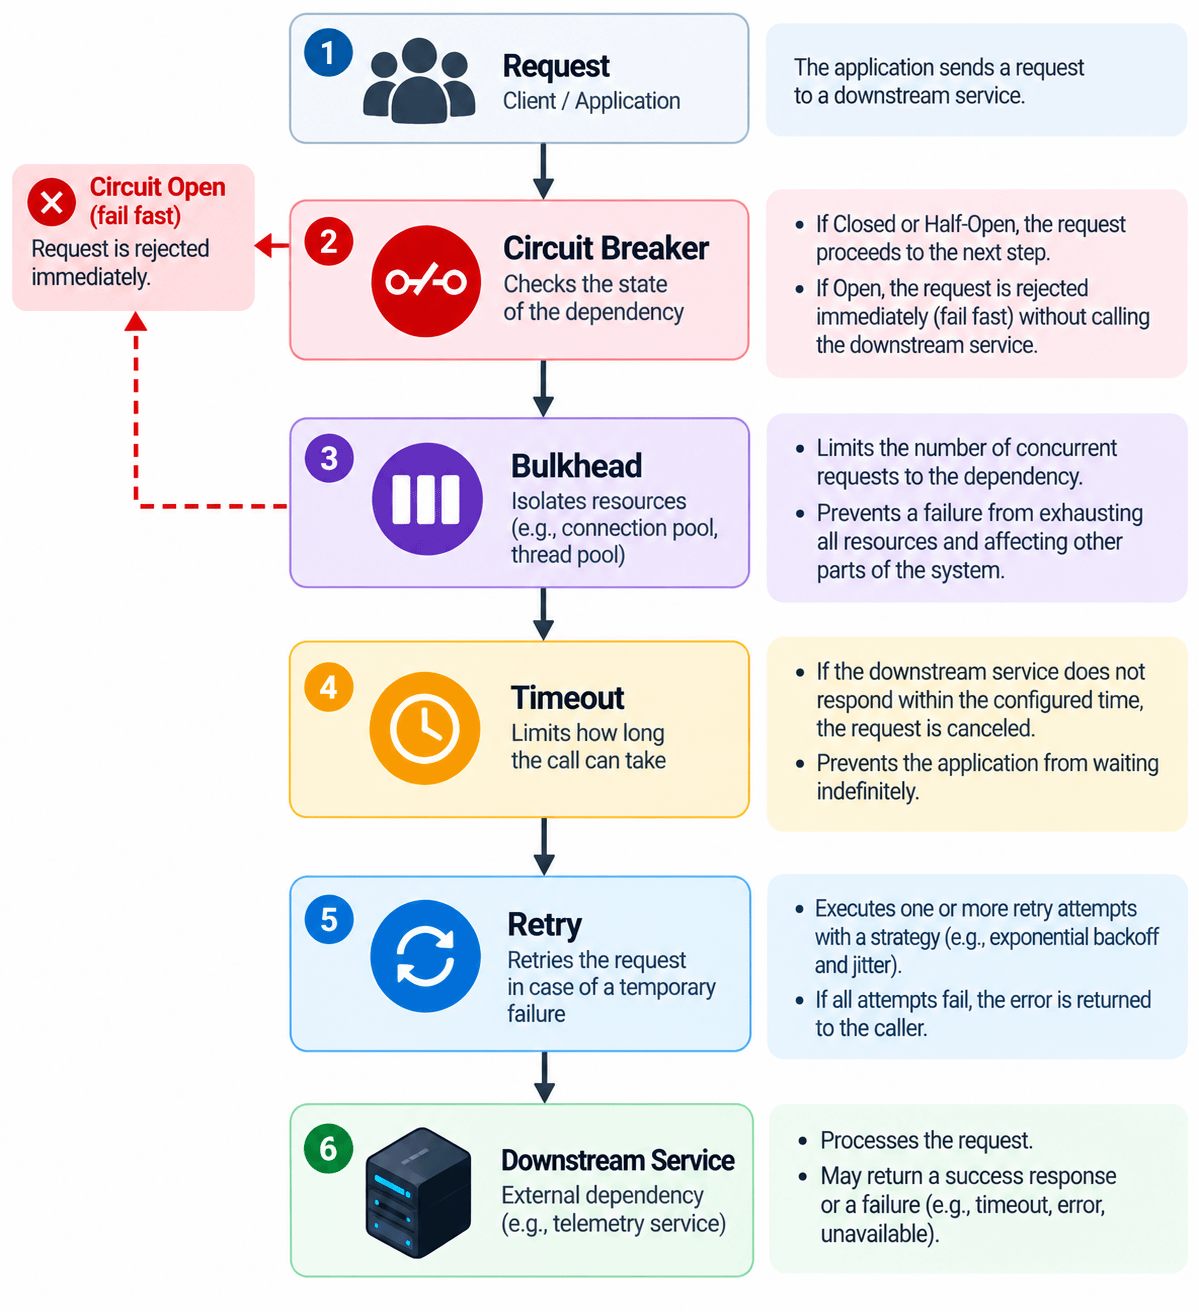
Esse fluxo é apenas uma representação conceitual. A ordem exata depende da biblioteca e das políticas utilizadas na aplicação.
O mais importante é compreender a responsabilidade de cada mecanismo:
| Padrão | Principal objetivo |
|---|---|
| Timeout | Limitar quanto tempo uma chamada pode esperar |
| Retry | Tentar novamente uma falha potencialmente temporária |
| Circuit Breaker | Parar temporariamente chamadas para uma dependência que está falhando |
| Bulkhead | Isolar recursos para limitar o impacto de uma falha |
Checklist para implementar Circuit Breaker
Antes de implementar o padrão, vale responder às seguintes perguntas:
- Existe uma chamada para uma dependência remota?
- Existe timeout configurado?
- Quais erros serão considerados falhas?
- Qual será o threshold para abrir o circuito?
- Quanto tempo o circuito permanecerá aberto?
- Como será feita a transição para Half-Open?
- Quantas chamadas serão permitidas durante o teste?
- O que acontecerá enquanto o circuito estiver aberto?
- Existe fallback?
- A operação pode ser processada posteriormente?
- Existe observabilidade suficiente para avaliar o comportamento?
- O impacto de uma falha está isolado por Bulkhead ou outro mecanismo?
Conclusão
O Circuit Breaker Pattern é uma das ferramentas mais importantes para lidar com falhas em sistemas distribuídos.
Seu princípio é simples: quando uma dependência está falhando continuamente, não devemos continuar tratando cada nova requisição como se fosse uma tentativa independente de sucesso.
O circuito começa fechado, monitora as chamadas, abre quando o limite de falhas é atingido e, depois de um período, utiliza o estado Half-Open para verificar se a dependência se recuperou.
O verdadeiro benefício, entretanto, não está simplesmente em “bloquear chamadas”. Está em conter a propagação de falhas e permitir que o restante do sistema continue funcionando da forma mais saudável possível.
Por isso, Circuit Breaker deve ser analisado em conjunto com Timeout, Retry, Bulkhead, observabilidade e estratégias de degradação.
Em arquiteturas distribuídas, falhas são inevitáveis. O trabalho da engenharia de software é projetar o sistema para que uma falha em uma dependência não se transforme automaticamente em uma falha de todo o sistema.
